問い合わせメール1,000件を要約するAPIを選ぶ時は、入力トークンの単価だけでは総額を比べられません。回答に使う出力、再試行の回数、検索などの追加機能も費用に入ります。まず同じ仕事の条件で試算し、次に少量の同じメールを各候補で処理して比べます。
ここでは、OpenAI API、AnthropicのClaude API、GoogleのGemini APIを直接使う、テキスト要約の比較を扱います。ChatGPT・Claude・Geminiの月額アプリ契約や、Azure・Amazon Bedrock・Vertex AI経由の料金とは区別してください。
- モデルIDと処理区分を固定し、100万トークン当たりの入力・出力単価を控えます。
- 同じ文章でもトークン数はモデルごとに計測します。
- 再試行を含む料金と、必要事項を落とさず要約できた件数を比べます。
ADVERTISEMENT
比較するメールと、合格とする要約を先に決める
比較用に20件程度のメールを用意します。送信してよい内容かを確認し、氏名や連絡先など不要な情報は置き換えます。短い問い合わせだけでなく、複数の依頼があるもの、日付の変更があるもの、回答期限が書かれていないものも含めます。
例えば、各モデルへ次の同じ指示を渡します。添付資料や外部検索は使わず、メール本文だけで行う仕事にそろえます。
次の問い合わせメールを「依頼内容」「対応期限」「次に必要な確認」の3項目で要約してください。本文にない日付や条件は補わず、「記載なし」としてください。各項目は1文にまとめてください。
結果を読む前に、各メールの重要な依頼、期限、未確認事項を人が控えます。料金が低くても、変更後の日付を落としたり、記載のない期限を作ったりする結果は採用しません。要約の短さだけを合格条件にすると、必要な情報を省いたモデルが安く見えてしまいます。
モデルIDと、通常処理の料金をそろえる
候補ごとに、APIへ指定するモデルID、通常処理かBatchか、入力・出力の単価、確認日を記録します。「OpenAIが安い」「Googleは無料」といった会社単位の比較では、選ぶモデルや有料枠が特定できません。
次の3モデルは単価計算を確認する例です。2026年10月10日に確認した通常処理の米ドル価格を使います。OpenAIはStandardの短い入力の区分、Claudeは1回の入力が10万トークン以下の区分、Geminiは有料枠のStandardです。キャッシュ、ツール、画像・音声、税・為替などはこの表に含めません。モデルの能力が同じだと示す比較ではありません。
| サービスとモデルID | 入力100万トークン | 出力100万トークン |
|---|---|---|
| OpenAI:gpt-5.6-luna | 0.20米ドル | 1.20米ドル |
| Claude:claude-haiku-5-5 | 0.10米ドル | 0.50米ドル |
| Gemini:gemini-3.1-flash-lite | 0.25米ドル | 1.50米ドル |
契約・実行前には、OpenAIの料金表、Claudeの料金表、Gemini APIの料金表の該当モデルを確認します。価格や提供状況、処理区分は変わるため、表の数値を今後も固定料金として使わないでください。
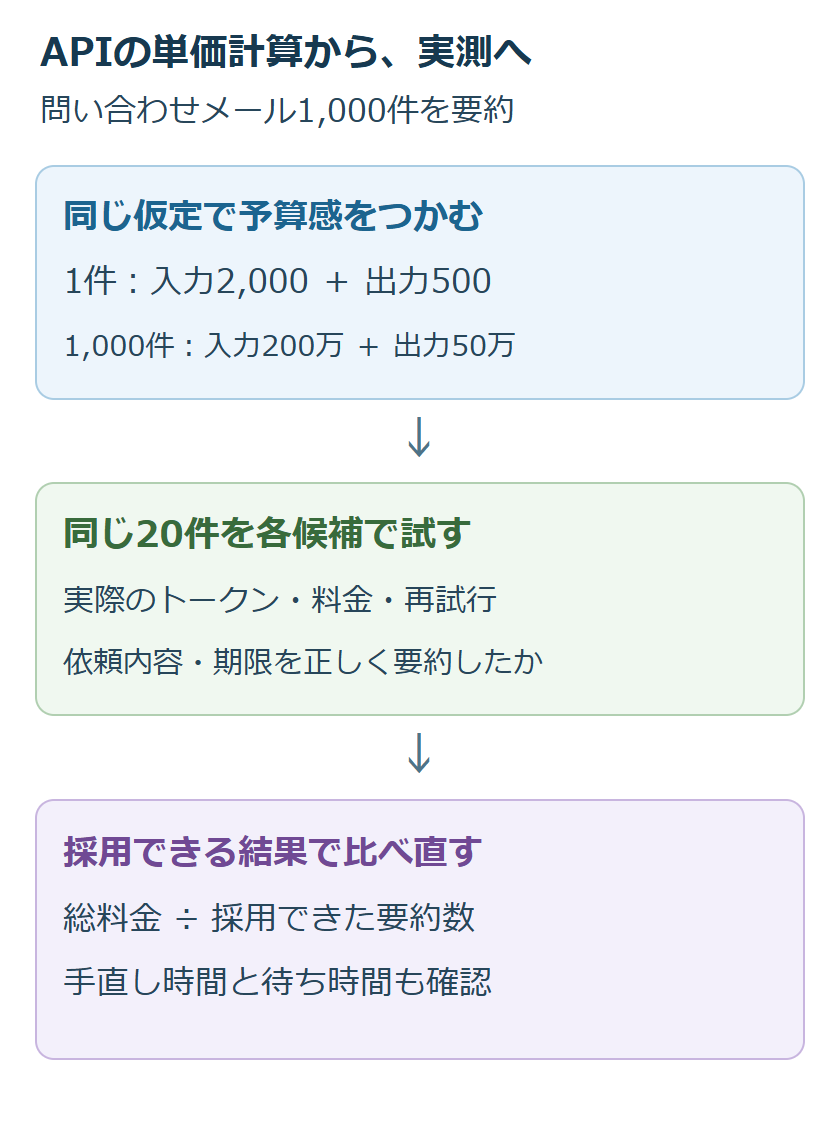
入力2,000・出力500トークンを1,000件処理するといくらか
まず計算方法をそろえるため、1件当たり入力2,000トークン、課金対象の出力500トークンと仮定します。指示文も入力に含め、1,000件をそれぞれ1回だけ処理します。同じメールを送った時に、3モデルの実際のトークン数がこの値になるという意味ではありません。
合計入力は200万トークン、合計出力は50万トークンです。入力の長さによる料金区分は各リクエストの条件で確認します。1,000件の入力合計が200万だから、1件の長文リクエストとして扱うわけではありません。通常入力と出力だけなら、「入力合計÷100万×入力単価+出力合計÷100万×出力単価」で求めます。
| モデル | 入力分+出力分 | 1,000件の仮定額 |
|---|---|---|
| gpt-5.6-luna | 2×0.20+0.5×1.20 | 1.00米ドル |
| claude-haiku-5-5 | 2×0.10+0.5×0.50 | 0.45米ドル |
| gemini-3.1-flash-lite | 2×0.25+0.5×1.50 | 1.25米ドル |
例えばOpenAIの行では、入力0.40ドルと出力0.60ドルの合計です。100万トークン単価を1,000トークン単価と取り違えたり、入力と出力の両方へ入力単価を掛けたりしないようにします。
同じ20件を試し、実際のトークンと再試行を記録する
試算後は、同じ20件と同じ指示で各候補を試します。モデルID、出力上限、推論の設定、応答に含まれる使用量、処理時間、エラー、再試行を記録します。設定項目は各モデルの仕様に合わせ、検証の途中で変えた場合は別条件として記録します。料金が発生する検証なので、最初から1,000件を流す必要はありません。
事前に入力サイズを見たい場合、OpenAIにはResponses APIの入力トークン計数、Claudeにはmessages.count_tokens、Geminiにはcount_tokensがあります。Claudeの事前計数は見積もりで、生成時の値と多少違う場合があります。事前計数だけでは出力分の料金は決まりません。
日本語の文字数を一律に2で割る方法や、別モデルで測ったトークン数の流用は避けます。実行後は各APIの使用量情報を使い、通常入力、キャッシュ、出力などの内訳をそのAPIの仕様に沿って確認します。推論に使うトークンなど、画面に見える回答文に含まれない処理もあるため、回答の文字数だけから出力料金を逆算しません。
再試行して使える要約になった場合、最初の処理も実行記録から消さずに集計します。20件の料金から1,000件を予測するなら、同じ内容の構成と処理条件が続くという仮定で50倍します。長文メールの割合が増えるなら、長文のサンプルを増やして計算し直します。
料金だけでなく、採用できた要約の件数を比較する
比較表には、総リクエスト数、総料金、採用できた件数、手直しが必要な件数、待ち時間を並べます。20件の入力に対して24回呼び出していたなら、その4回の追加処理も費用と時間へ含めます。
費用の見方として「検証全体のAPI料金÷採用できた要約数」を計算できます。架空の例で、0.08ドル使って20件採用できた候補は1件当たり0.004ドル、0.06ドル使って10件だけ採用できた候補は0.006ドルです。総料金だけなら後者が低くても、使える結果1件当たりでは逆転します。
この値にも人の修正時間は入っていません。重要事項を毎回人が書き直すモデルなら、その時間も記録します。問い合わせ対応の前処理では、料金差よりも期限や依頼の見落としが問題になるため、合格条件を満たした候補の中で費用と待ち時間を比べます。
キャッシュ・Batch・検索を使うなら、別の条件で再計算する
同じ指示を送るからといって、毎回キャッシュ料金が適用されるとは限りません。使用量の内訳で適用を確認し、キャッシュ書き込み・読み出しや保存時間の料金がある場合は加えます。通常入力の合計へ、キャッシュ分を重複して足さないようにしてください。
Batchには通常処理と異なる料金があり、各社の料金表で区分が分かれています。ただし、結果をすぐ返す問い合わせ対応と、夜間にまとめて要約する処理では待てる時間が違います。Batchの単価と通常処理の応答速度を組み合わせて、1つの条件のように比較しないでください。
検索やファイル保存などを追加した場合も、テキスト入出力だけの試算へ戻って合計し直します。採用時には、モデルID、処理区分、同じ入力での結果、実測料金、価格確認日を残します。これで料金改定やモデル変更の際も、同じ仕事を基準に再比較できます。
超解決 第一編集部
疑問解決ポータル「超解決」の編集チーム。正確な検証と、現場視点での伝わりやすい解説を心がけています。
生成AIの人気記事ランキング
- 【生成AI】学術論文にChatGPTやMidjourneyの図表を載せる時のジャーナル規定
- 【速報 2026年7月】ChatGPTで会話が読み込めない・続けられない時の公式障害と復旧状況
- 【生成AI】ファッションコーデ提案にChatGPTやGeminiを使う時のプロンプト
- 【生成AI】学生がChatGPT EduやGemini学割を使う時の申請条件と必要書類
- 【生成AI】ChatGPT/Claudeのデータが海外に保管される時の越境問題確認
- 【生成AI】社内情報をChatGPTに貼る前に機密漏洩を防ぐマスキング手順
- 【生成AI】受験勉強でChatGPTに過去問解説を依頼する時のプロンプト書き方
- 【ChatGPT】ドル建てから円建てへ変更したい時の確認|解約前の注意点
- 【生成AI】教材作成でChatGPTを使う時の出典明記と著作権配慮
- 【ChatGPT】解約したのに請求された時の確認|対象期間・別契約・返金窓口